Знайома ситуація: спроєктували бінарний протокол, усе красиво, struct один-в-один як у специфікації. Шлемо по UART чи CAN, а приймач отримує кашу. Або: працює на Cortex-M4, а на M0+ вилітає в HardFault з “ну я ж нічого дивного не робив”.
Спойлер: struct у C - це не “група змінних”, це конкретний малюнок байтів, і малюємо його не ми, а компілятор. Виводи нижче отримані з GCC 13.3 (x86-64), arm-none-eabi-gcc 13.2.1, pahole 1.25 і rustc 1.84; з іншими версіями деталі asm можуть відрізнятися.
TL;DR
- Компілятор вставляє між полями невидимі байти (padding), щоб кожне поле лежало за адресою, кратною його
alignof.- Порядок полів впливає на розмір. Сортуйте від більшого до меншого й перевіряйте через
pahole.packedприбирає padding, але скидає вирівнювання всієї структури до 1: на Cortex-M0 побайтово читаються навіть поля на офсеті 0.packed, aligned(4)частково це лікує.- HardFault на M0 дає не сам
packed, а код, який “забуває” про невирівняність: кастuint8_t *=>uint32_t *або взяття адреси packed-поля.packed≠ “готовий формат для дроту”: є ще порядок байтів і сміття в padding. Для протоколів серіалізуйте явно.- Вирівнювання - питання ABI:
doubleна i386 вирівнюється по 4, на ARM і x86-64 по 8. Вирівнюються навіть аргументи в регістрах.- На Cortex-M7 з D-cache DMA-буфер вирівнюють по кеш-лінії (32 байти) і за адресою, і за розміром, інакше cache maintenance зачепить сусідні змінні.
- C++ додає прихованих байтів (vptr), Rust за замовчуванням сам переставляє поля. Різниця між мовами не у “вирівнюванні”, а в тому, що кожна з них гарантує.
Залізо: навіщо взагалі вирівнювання
Пам’ять - не нескінченна стрічка байтів, а набір комірок, до яких ходить шина певної ширини.
- Один банк, 8-бітні комірки. Щоб прочитати 32-бітне число, потрібно 4 цикли: байт => байт => байт => байт, а потім склеїти.
- Кілька паралельних банків (наприклад, 4 по байту). Якщо 32-бітне значення лежить на адресі, кратній 4, всі чотири банки віддають свій байт одночасно: 1 цикл. Якщо значення “розрізане” між двома сусідніми словами, потрібні два доступи плюс зсув і злиття.
Звідси природне вирівнювання (natural alignment): значення типу T має лежати за адресою, для якої addr % alignof(T) == 0. Для скалярних типів alignof зазвичай дорівнює sizeof, але не завжди: останнє слово за ABI платформи (нижче побачимо, як double на i386 вирівнюється лише по 4). Структура мусить розкласти поля так, щоб ця умова виконувалась для кожного з них.
На 32-бітному ядрі вирівняне слово читається за один доступ до шини, а double - за два, бо це два слова. Невирівняний доступ коштує більше: на одних ядрах прихованими додатковими циклами, на інших (Cortex-M0/M0+) - HardFault.
Експеримент №1: вгадай sizeof
Чотири структури. Спробуйте вгадати розміри на папері, перш ніж дивитись далі:
| |
| |
Наївна сума полів проти реальності:
| struct | сума полів | реально (x86-64, ARM EABI) | alignof |
|---|---|---|---|
a_t | 3 | 4 | 2 |
b_t | 7 | 8 | 4 |
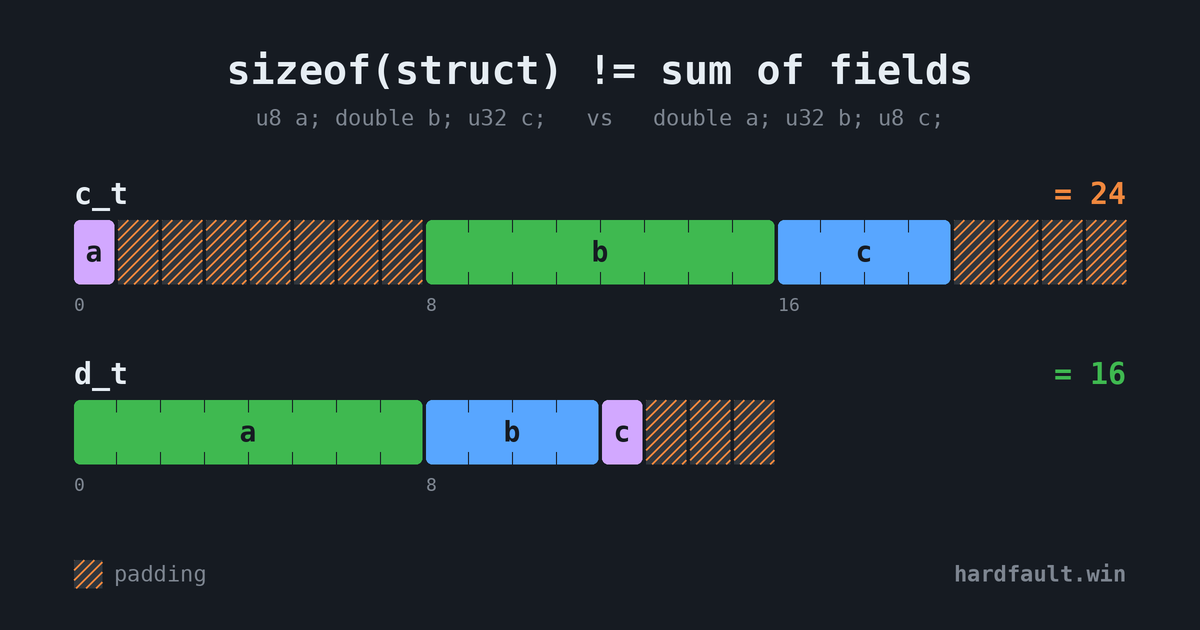
c_t | 13 | 24 | 8 |
d_t | 13 | 16 | 8 |
Колонка alignof - ключ до всього: вирівнювання структури дорівнює найбільшому вирівнюванню серед її полів.
a_t і b_t очевидні: між u8 та u16 один байт padding, між u8 і u32 теж.
А от c_t зазвичай ламає мозок. Рахуємо: a (1 байт), 7 байт padding, b (8 байт, офсет 8), c (4 байти, офсет 16). Закінчуємо на 20. Чому ж 24?
Бо розмір структури мусить бути кратним її вирівнюванню (тут 8, від double). Інакше в масиві c_t arr[2] другий елемент поїде на офсет 20, і його double стане невирівняним. Тож у кінець додається ще 4 байти tail padding. Те саме правило працює рекурсивно для структур усередині структур.
d_t каже те саме з іншого боку: ті самі типи, але великий double стоїть першим, тож внутрішніх дірок немає, а хвостовий padding лише 3 байти (13 => 16).
Порядок полів = економія пам’яті, і безкоштовно. Практичне правило: сортуйте поля за спаданням розміру (точніше, за спаданням alignof).
| |
Попросити компілятор сказати самому
| |
Бачимо і внутрішній padding, і хвостовий (4 байти для c_t, 3 для d_t). Для реального проєкту -Wpadded надто балакучий, щоб тримати його ввімкненим постійно, але для разової ревізії структур - те, що треба.
Експеримент №2: дивимось через pahole
-Wpadded корисний, але найнаочніше дірки показує pahole (пакет dwarves). Він читає DWARF-інформацію з об’єктного файлу і малює структуру так, як вона лежить у пам’яті. Працює й з об’єктниками під ARM.
| |
| |
| |
Усе, що ми вирахували вручну, тут написано прямо: діра 7 байт, хвостовий padding 4, 13 корисних байтів у 24. А ось d_t:
| |
Жодних XXX hole, лише 3 байти в хвості.
Три граблі, на які можна наступити
1. Голий pahole file.o може мовчати. Без жодної помилки, exit code 0. Причина: структури в прикладі анонімні (typedef struct { ... } c_t;), а голий виклик друкує лише структури з тегом. Формат DWARF тут ні до чого: з -gdwarf-4 поведінка та сама. Лікується двома способами:
| |
2. Тип, який ніде не використано, у DWARF не потрапляє. GCC за замовчуванням викидає невикористані типи з debug-інформації. Якщо структура фігурує лише в sizeof, pahole скаже type 'X' not found. Або заведіть хоча б одну змінну цього типу (як gc і gd вище), або попросіть GCC нічого не викидати:
| |
3. Потрібен -g. Без debug-інформації pahole немає з чого читати.
Експеримент №3: packed і заголовок прошивки
Тепер реалістичний кейс: заголовок образу прошивки, який лежить у Flash і формат якого зафіксований байт-у-байт. Цей файл використовуємо в наступних двох експериментах, тож тут він повністю:
| |
У natural-варіанті між flags (офсет 6) і crc компілятор вставляє 1 байт padding, crc стає на офсет 8, розмір 12. У packed padding немає: crc на офсеті 7, розмір 11.
На другій схемі видно саме той випадок із розділу про банки пам’яті: crc починається в одному слові, а закінчується в іншому.
Зверніть увагу на _Static_assert. Вони компілюються в нуль байтів, але якщо хтось через рік додасть поле чи змінить прапор компілятора, впаде збірка з людським повідомленням, а не прошивка в полі.
packed виглядає як ідеальне рішення. Тепер про ціну.
Експеримент №4: скільки коштує packed
Функція read_crc з fw.c читає невирівняне поле:
| |
Компілюємо під три конфігурації. У .s немає імен полів C, лише зсуви на кшталт [r0, #7], тому -fverbose-asm додає коментарі, а sed вирізає потрібну функцію:
| |
| |
| |
| |
Cortex-M4 (ARMv7-M, невирівняний доступ підтримується апаратно):
| |
Одна інструкція. GCC лише ставить коментар @ unaligned. Ціна прихована: ядро всередині робить кілька доступів до шини замість одного, тож це повільніше, але в асемблері цього не видно.
Cortex-M0 (ARMv6-M, апаратної підтримки немає):
| |
Тут уже видно, що відбувається: чотири ldrb (по байту), три зсуви, три злиття. Десять інструкцій замість однієї.
Cortex-M4 з -mno-unaligned-access: те саме, але з barrel shifter в orr
| |
Thumb-2 уміє зсувати другий операнд прямо в orr, тому окремі lsls не потрібні: 7 інструкцій замість 10.
Ключовий висновок: ціну packed визначає ядро. Компілятор знає, що поле невирівняне (бо ви самі написали packed), і підбирає безпечну послідовність для конкретної архітектури. Тож у цьому випадку HardFault не буде, буде лише повільніше й довше.
Сюрприз: побайтово читається навіть magic
packed прибирає не лише padding між полями: він скидає alignof всієї структури до 1. Компілятор більше не може припускати, що сам вказівник h вирівняний, тому на M0 навіть magic на офсеті 0 збирається з байтів:
| |
Ліки - повернути структурі вирівнювання, не повертаючи padding між полями: __attribute__((packed, aligned(4))) (тип fw_header_packed_a4_t у fw.c). Тепер компілятор знає, що база вирівняна по 4, і поля на “чесних” офсетах читаються однією інструкцією навіть на M0 (коментарі в asm - мої):
| |
Навіть невирівняний crc подешевшав: компілятор читає вирівняне слово з офсету 8 і доклеює один байт. Легально це саме тому, що байт 11 належить структурі (tail padding).
| функція | M4 | M4 -mno-unaligned-access | M0 |
|---|---|---|---|
read_crc (packed) | 1 | 7 | 10 |
read_magic (packed) | 1 | 7 | 10 |
read_magic_a4 (packed + aligned(4)) | 1 | 1 | 1 |
read_crc_a4 (packed + aligned(4)) | 1 | 3 | 4 |
Кількість інструкцій без bx lr.
Важливо
aligned(4)повертає tail padding:sizeof(fw_header_packed_a4_t) == 12, а не 11. Для заголовка у Flash, який ви самі розмічаєте, це зазвичай прийнятно. Для формату, де після 11-го байта одразу йде payload, - ні. Тому_Static_assertна розмір уfw.cстоїть і для цього типу.
Де M0 справді падає
HardFault на M0 приходить, коли компілятор не знає, що адреса невирівняна. Два типові способи йому “не сказати”: каст байтового буфера та взяття адреси packed-поля.
Каст вказівника
| |
| |
Звичайний ldr. Ніякого @ unaligned, ніякої побайтової збірки: для компілятора каст uint8_t * => uint32_t * означає обіцянку “тут точно вирівняно по 4” (а за стандартом C ще й порушує strict aliasing). Якщо buf + 1 не кратне 4, то на M0/M0+ це миттєвий HardFault, а на M3/M4/M7 - тихий повільний доступ (поки не ввімкнемо trap, див. нижче).
Звідки на M0 окремий adds?
У Thumb-1 LDR із immediate-офсетом кодує зсув, кратний 4 (#0..#124), тому [r0, #1] просто не існує як інструкція. Сам набір інструкцій M0 нагадує, що слово мусить бути вирівняне.
Адреса packed-поля
Другий спосіб - передати адресу поля туди, де чекають звичайний вказівник:
| |
Усередині crc_of немає жодної інформації про packed: там звичайний ldr r0, [r0], а приходить у нього h + 7. На M0 - HardFault. GCC про це попереджає за замовчуванням:
| |
ОбережноЦе найчастіший реальний сценарій: структура
packed, а поле передають у CRC- чи parse-функцію за вказівником. Попередження-Waddress-of-packed-memberварто тримати як помилку (-Werror=address-of-packed-member).
Як читати правильно
У cast.c є ще два варіанти. Ось що з них робить компілятор:
| |
memcpy коректний скрізь, і на M4 згортається в один ldr. Але на M0 GCC 13 залишив справжній виклик бібліотечної memcpy. get_u32le зі зсувами коректний скрізь, на M4 GCC сам розпізнає патерн і теж згортає його в один ldr, а на M0 дає ту саму побайтову збірку без виклику. І головне: він фіксує порядок байтів, про що memcpy нічого не знає. Для читання з протокольних буферів це найкращий вибір.
Компілятор і санітайзер як сторожі
-Wcast-alignна ARM попереджає про кастuint8_t *=>uint32_t *(cast increases required alignment of target type). На x86 той самий прапор мовчить, бо архітектура терпить невирівняні доступи. Там потрібен-Wcast-align=strict.- Якщо бізнес-логіка тестується на хості,
-fsanitize=alignmentловить невирівняний доступ у рантаймі, навіть на x86:
| |
| |
get_u32le і memcpy проходять, а read_cast зупиняє тест з точним рядком.
Як знайти невирівняні доступи на M3/M4/M7
На цих ядрах невирівняний доступ мовчки працює, тобто баги ховаються. Але trap можна ввімкнути:
| |
Тепер кожен невирівняний LDR/STR дасть UsageFault (з прапорцем UNALIGNED в UFSR, а якщо UsageFault-обробник не ввімкнений, ескалюється в HardFault). Це не про “повільні місця”, а про всі місця, де ви покладаєтесь на апаратну терпимість. Корисно, щоб на M4 відловити код, який “випадково” зламається при міграції на M0.
Один нюанс: з trap’ом код із read_crc вище (ldr r0, [r0, #7] @ unaligned) почне падати, бо GCC за замовчуванням вважає невирівняний ldr допустимим. Тож разом із trap’ом додавайте -mno-unaligned-access: тоді компілятор для packed-полів сам перейде на побайтове читання. Підсумок: прапор компілятора + trap = чесна перевірка, що код переносимий на M0.
Малі типи: LDRB, LDRSB, LDRH
Байт можна прочитати з будь-якого офсету однією інструкцією, і він одразу опиняється в молодших бітах регістра: нічого зсувати чи маскувати вручну не треба.
| |
| |
| |
| |
| |
ldrbбере байт з непарного офсету й розширює нулями до 32 біт - на обох ядрах одна інструкція.- Для знакового байта на M4 є
ldrsbз immediate-офсетом, на M0 такої форми немає (у Thumb-1LDRSBвміє лише регістровий офсет), томуldrb+sxtb. uint16_tна офсеті 3 вже невирівняний: на M4 цеldrhз@ unaligned, на M0 - збирання з двох байтів.
Порівняйте з архітектурами без байтових завантажень: там довелося б читати ціле слово, зсувати й маскувати & 0xFF. На ARM апаратура бере це на себе.
Padding - це ще не все: не шліть struct в мережу
Ви можете подумати: “Ага, packed, 11 байтів, шлю структуру як є”. Ні. Подивімося, що реально лежить у пам’яті звичайної (не-packed) структури і що має піти в протокол:
| |
| |
memset(..., 0xCC, ...) імітує стек: значення padding-байта стандартом не визначене, тож у реальному коді там буде те, що лежало на стеку до цього. Тобто сира структура в проводі - ще й витік вмісту пам’яті. Плюс її порядок байтів диктує архітектура відправника. Cortex-M (на практиці) і x86 - little-endian, але перший же big-endian партнер по мережі зламає все.
Тому правило таке: packed - для форматів, що лежать у Flash і читаються тим самим кодом (заголовки образів, конфіг-блоки). Усе, що йде назовні, серіалізуйте явно: зсувами, як put_u32le/get_u32le, у Rust - to_le_bytes()/from_le_bytes(). Так ви одночасно вирішуєте padding, endianness і вирівнювання.
Попередження
packedне для MMIO-регістрів. Регістри периферії мають бути природно вирівняні й читатися своєю шириною, аpackedможе перетворити 32-бітний доступ на чотири байтові, які регістр не підтримує або на які реагує інакше (наприклад, read-to-clear).
Вирівнювання - питання ABI, а не мови
Чому double у структурі вирівнюється по 8, хоча шина 32-бітна? Бо так сказав ABI: менше доступів до шини ціною більшого padding. Перевіримо: той самий sizes.c, але під 32-бітний x86:
| |
На i386 System V double усередині структури вирівнюється лише по 4, тож c_t стискається з 24 до 16 (b на офсеті 4, а не 8). На ARM EABI (AAPCS) та x86-64 вимога 8. Висновок: розмір структури не переноситься між платформами, і це ще одна причина ставити _Static_assert.
А що з double на Cortex-M4?
| |
| |
| |
Вирівняний double вантажиться однією vldr.64. Для невирівняного компілятор не може використати vldr (на невирівняній адресі вона дає UsageFault завжди, див. вище), і навіть ldrd не може. Тож бере два одиночних ldr і перекладає їх у FPU-регістр через vmov.
pahole показує ціну в байтах:
| |
| |
| |
FPU на M4 - одинарної точності
fpv4-sp-d16вміє лишеfloat. Функціяaddзdbl.c(a + bдляdouble) компілюється уbl __aeabi_dadd, тобто в програмну емуляцію, аaddfдляfloat- в однуvadd.f32. Padding навколоdoubleна цьому тлі дрібниця. Якщо точність дозволяє, берітьfloat.
Регістри та стек теж вирівнюються
Правила вирівнювання діють не лише в структурах. AAPCS передає перші аргументи в r0 - r3, і 64-бітне значення мусить зайняти парну пару регістрів:
| |
| |
Компілятор пише константи в десятковому вигляді, коментарі з hex і поясненнями - мої:
| |
a іде в r0, r1 пропускається, b іде в r2:r3. Порядок аргументів має значення так само, як порядок полів: sink(uint64_t b, uint32_t a) вліз би в r0 - r2 і залишив r3 вільним для ще одного аргументу. Якби аргументів не вистачило регістрів, на стеку 64-бітне значення так само лягло б на адресу, кратну 8.
Сам стек теж вирівняний: AAPCS вимагає, щоб SP був кратний 8 на межах публічних функцій, а Cortex-M при вході у виняток вирівнює кадр по 8 (CCR.STKALIGN; на M0 завжди). А от розміщення локальних змінних усередині кадру - справа компілятора: кілька char цілком можуть лежати поруч на непарних адресах, тому покладатися тут ні на що не варто.
C++: те саме, плюс сюрпризи
C++ повністю успадковує правила C, але додає власні джерела прихованого розміру. Усі приклади в одному файлі:
| |
| |
| |
| |
Що тут видно:
- vptr. Одна
virtual-функція, і об’єкт розтовстів: на 32-бітному таргеті +4 байти (4 => 8), на x86-64 аж до 16 через вирівнювання.nmпоказує, що vtable є лише уWithVirt(друга - службова, з RTTI). У масивах поліморфних об’єктів у RAM це відчутно, тому вбудований код часто волієswitchабо таблиці функцій. - EBO. Порожній базовий клас не займає місця (4), а порожнє поле-член займає (8, бо кожен об’єкт мусить мати власну адресу).
[[no_unique_address]](C++20) дає той самий ефект для полів-членів. alignas(32)- стандартний спосіб для DMA-буферів. У C довго було лише розширення компілятора (__attribute__((aligned)),__alignof__),_Alignas/_Alignofз’явились у C11, а в C23alignas/alignofстали повноцінними ключовими словами, як у C++.- Не standard-layout.
static_assertу файлі перевіряє, щоWithVirtне standard-layout: покладатися на порядок полів,offsetofчи сумісність із C для таких типів не можна. Для того, що йде у Flash чи в протокол, тримайте прості структури й ставтеstatic_assert(std::is_standard_layout_v<T>).
Rust: інша філософія
У C/C++ порядок полів у пам’яті = порядок у коді. У Rust за замовчуванням (repr(Rust)) компілятору дозволено переставляти поля, щоб зекономити місце.
| |
| |
Ті самі u8, u32, u16: у C це 12 байт, а в repr(Rust) компілятор переставив поля (b на 0, c на 4, a на 6) й отримав 8, рівно як наша “відсортована” struct good у C. Звільнення від людського фактора, але є застереження: layout repr(Rust) не гарантований і може змінитися між версіями компілятора. Тому для всього, що виходить за межі вашого Rust-коду (FFI, регістри, Flash, мережа), потрібен явний #[repr(C)] або #[repr(C, packed)].
const _: () = assert!(...) у файлі - Rust-аналог _Static_assert: невдала перевірка зупиняє компіляцію.
Layout кожного типу від компілятора: -Z print-type-sizes (nightly)
| |
Це найближчий аналог pahole для Rust: видно і переставлені поля, і padding.
Крім того:
- Niche optimization.
Option<&u32>займає стільки ж, скільки&u32(8 на 64-бітному хості): нульовий вказівник для&Tзаборонений, тожNoneкодується ним, а окремий тег не потрібен. - Для вирівнювання DMA-буферів:
#[repr(C, align(32))]на обгортці над масивом (DmaBufу файлі). - Посилання на поле
packed-структури. Rust не пустить у UB:
| |
| |
Це та сама пастка, що й read_via_ptr у C, але в Rust вона hard error, а не попередження. Читайте поле копією (let crc = h.crc;), як у прикладі вище.
Зведена таблиця
| C | C++ | Rust (repr(Rust)) | Rust (repr(C)) | |
|---|---|---|---|---|
| Порядок полів | як у коді | як у коді (база => похідний) | не гарантований, компілятор оптимізує | як у коді |
| Padding | природне вирівнювання | те саме | мінімізується автоматично | як у C |
| Packed | __attribute__((packed)) / #pragma pack | те саме | #[repr(packed)] | #[repr(C, packed)] |
| Вирівнювання для DMA | aligned(N) / _Alignas (C11), alignas (C23) | alignas(N) | #[repr(align(N))] | #[repr(C, align(N))] |
| Прихований розмір | немає | vptr, бази | немає | немає |
| Перевірка в compile time | _Static_assert | static_assert | const _: () = assert!(...) + offset_of! | те саме |
| Інструменти | pahole, -Wpadded, -Wcast-align | те саме + nm -C для vtable | -Z print-type-sizes | те саме |
| Придатність для FFI/Flash | так | лише standard-layout | ні | так |
Золоті правила розробника
- Сортуйте поля від більшого до меншого і перевіряйте результат у
pahole -C <тип>(або-Wpadded). Не рахуйте в голові. - Фіксуйте розмір і зсуви через
_Static_assert/static_assert/const assert!. Це страховка від сюрпризів при зміні платформи, компілятора чи прапорів. packedлише для форматів, що лежать у Flash. Не для MMIO, не “щоб влізло” в кожну структуру. Якщо формат дозволяє, додайтеaligned(4), щоб не платити побайтовим читанням за вирівняні поля.- Усе, що йде в мережу, серіалізуйте явно.
packedне лікує ні endianness, ні сміття в padding. - Не беріть адрес поля
packed-структури й не кастуйте байтовий буфер уuint32_t *. Для читання з буфера єget_u32le-подібні функції абоmemcpy. Тримайте-Wcast-alignі-Waddress-of-packed-memberувімкненими, на хості --fsanitize=alignment. - Пам’ятайте про ядро. На M0/M0+ нечесний невирівняний
ldr= HardFault. На M3/M4/M7 це мовчки повільно (а дляldrd/ldm/vldr- теж fault), ловиться черезUNALIGN_TRPразом із-mno-unaligned-access. - У Rust усе, що виходить за межі Rust-коду, має
#[repr(C)].repr(Rust)лишайте для внутрішніх структур.